Materiais do vídeo
StockfishEngine · grátis, open source↗Leela Chess ZeroEngine de rede neural · open source↗Maia ChessIA que joga como humano · U. Toronto↗AlphaZeroGoogle DeepMind · 2017↗Como a NNUE funcionaDocumentação oficial · GitHub↗Estudo dos empatesarXiv · 2026 · 3,9 milhões de partidas↗Vidit x PraggnanandhaaChessBase · Candidatos 2024↗A IA mudou o xadrezBloomberg · março de 2026↗Por que os melhores do xadrez estão jogando "pior" de propósito
A IA deixou o xadrez de elite tão preparado que os empates subiram. A partida que mostrou a saída e como Stockfish, AlphaZero, Leela e Maia pensam por dentro.
Se você veio do vídeo: aqui está a história completa da partida, como as IAs de xadrez funcionam por dentro (do Stockfish ao AlphaZero) e os estudos que mostram por que a IA deixou o xadrez de elite mais empatado. No fim tem um método pra usar engine sem virar refém dela.
| O que | Pra que serve | Preço | Link |
|---|---|---|---|
| Stockfish | A engine mais forte do mundo, a que todo profissional usa | Grátis, open source | stockfishchess.org |
| Leela Chess Zero | Engine de rede neural que aprendeu jogando contra si mesma | Grátis, open source | lczero.org |
| AlphaZero | A IA do Google DeepMind que aprendeu xadrez do zero | Não está disponível pra uso | Blog da DeepMind |
| Maia Chess | IA treinada pra jogar como humano, com erros e tudo | Grátis | maiachess.com |
| A partida do vídeo | Vidit x Praggnanandhaa, Candidatos 2024 | Grátis | Relato da ChessBase |
| Estudo dos empates | 3,9 milhões de partidas antes e depois das engines neurais | Grátis | arXiv |
A partida: o lance que ninguém esperava
Abril de 2024, Toronto. O Torneio de Candidatos decide quem desafia o campeão mundial. Na terceira rodada, dois indianos se enfrentam: Vidit Gujrathi, de brancas, e Rameshbabu Praggnanandhaa, o "Pragg", de 18 anos, de pretas.
O Vidit abre com a Espanhola (também chamada de Ruy Lopez), uma das aberturas mais estudadas da história. Depois de 1.e4 e5 2.Cf3 Cc6 3.Bb5 a6 4.Ba4, o normal é as pretas seguirem com 4...Cf6. O Pragg jogou 4...f5.

Esse avanço do peão tem nome: Schliemann Atrasada (ou Deferred Schliemann). É uma linha agressiva, que abre o lado do próprio rei, e que quase não aparece na elite. Segundo o Indian Express, o Nakamura chamou a escolha de "uma variante completamente insana". O Peter Leko, que disputou o título mundial em 2004 e estava comentando ao vivo, disse que estava sem palavras: "Era pra eu ser especialista em Espanhola, mas com certeza eu não via essa posição havia 25 anos".
O efeito no tabuleiro veio rápido. Segundo o relato da FIDE, o Vidit gastou quase 20 minutos no oitavo lance e mais de 20 minutos pouco depois. Saiu da preparação, gastou relógio, errou no meio-jogo e perdeu.
O detalhe que muda tudo: o Pragg não improvisou. Segundo o Indian Express, ele estudou a linha naquela manhã com o treinador, o grande mestre Peter Svidler. Foi preparação caseira pensada pra pegar o adversário num lugar onde ele não tinha decorado nada.
Uma correção sobre o vídeo: quem disse a frase dos 25 anos foi o Leko, comentando a partida. Ele não era o adversário. E a ideia de que "o computador considerava o lance inferior" precisa de nuance: a teoria trata a Schliemann Atrasada como arriscada, mas a ChessBase relata que as engines avaliaram a posição como próxima do equilíbrio nos primeiros lances. O ponto não é jogar mal. É jogar algo menos estudado que você conhece melhor que o rival.
Por que isso virou estratégia
O problema: todo mundo usa a mesma máquina
Pensa numa prova em que todos os alunos estudaram pelo mesmo gabarito. As respostas saem iguais e ninguém se destaca. É isso que aconteceu no xadrez de elite.
O Stockfish é grátis e open source. Todo profissional tem acesso à mesma engine, com a mesma força, rodando no próprio computador. Quando os dois jogadores preparam a abertura com a mesma ferramenta, eles chegam às mesmas linhas "perfeitas", e as partidas tendem a acabar em posições equilibradas.
O exemplo mais famoso é o Mundial de 2018. Segundo a Bloomberg, o Magnus Carlsen e o Fabiano Caruana jogaram 12 partidas clássicas, mais de 50 horas de jogo, e todas terminaram empatadas. Foi a primeira vez que isso aconteceu num campeonato mundial, uma competição que existe desde 1886. O título foi decidido nas partidas rápidas de desempate.
O que os dados mostram
Em junho de 2026, os economistas Dan Ben-Moshe e David Genesove publicaram um estudo com 3,9 milhões de partidas clássicas jogadas entre 2015 e 2023. Eles usaram como marco o outono de 2020, quando o Stockfish passou a usar rede neural (a NNUE, explicada abaixo) e a melhor análise do mundo ficou acessível em qualquer notebook.
O resultado: até o fim de 2021, a taxa mensal de empates no xadrez clássico subiu cerca de 4 pontos percentuais. O aumento apareceu em todas as faixas de rating e não era uma tendência que já vinha de antes. Os jogadores de rating mais baixo foram os que mais ganharam força relativa, o que sugere que a tecnologia se espalhou por todos os níveis.
Pra ter noção da escala: a Bloomberg lembra que, por décadas, a taxa de empate entre mestres no clássico ficou perto de 50%. Quatro pontos em cima disso é muita partida.
A resposta dos jogadores
Se a máquina iguala todo mundo na abertura, a vantagem passa a estar no que a máquina não prepara: a surpresa. A Techspot resume a virada assim: grandes mestres mais jovens passaram a escolher linhas um pouco inferiores, mas menos estudadas, pra fugir da preparação perfeita do rival.
O Carlsen foi por outro caminho. Ele abriu mão de defender o título mundial depois de 2021 e virou um dos rostos do Freestyle Chess, formato que sorteia uma entre 960 posições iniciais (as peças de trás embaralhadas). Sem posição inicial fixa, não tem árvore de abertura pra decorar.
Linha do tempo: das máquinas que calculavam às que aprendem
| Ano | O que aconteceu |
|---|---|
| 1956 a 1961 | Surge o algoritmo alfa-beta, base da busca das engines clássicas |
| 1997 | O Deep Blue, da IBM, vence o campeão mundial Garry Kasparov por 3,5 a 2,5 |
| 2017 | O AlphaZero, da DeepMind, aprende xadrez sozinho em 9 horas |
| 2018 | Nasce o Leela Chess Zero, versão aberta da ideia do AlphaZero. No mesmo ano, a NNUE aparece no shogi |
| 2018 | Mundial Carlsen x Caruana: 12 empates em 12 partidas clássicas |
| 2020 | Maia, a IA que imita humanos. Em agosto, o Stockfish adota a NNUE |
| 2022 | O Leela troca redes convolucionais por transformers |
| 2024 | 4...f5 do Pragg nos Candidatos |
| 2026 | Stockfish 19 (setembro) e Maia-3 (ICLR) |
1. Stockfish: a calculadora que ganhou intuição
O que é
O Stockfish é a engine mais forte do mundo e é feita por voluntários. O código é aberto (licença GPLv3) e você pode baixar de graça. É o que roda por trás da análise do Lichess e de boa parte das ferramentas de xadrez que você conhece. Quando este texto foi escrito (outubro de 2026), a versão mais recente era o Stockfish 19, lançado em 5 de setembro de 2026.
Como funciona por dentro: busca
Imagina que você vai jogar e pensa "se eu faço isso, ele faz aquilo, aí eu faço isso...". Cada possibilidade abre mais possibilidades. Isso forma uma árvore de jogo: a raiz é a posição atual, cada galho é um lance.
O problema é que essa árvore explode. Com uns 30 lances possíveis por posição, olhar 10 lances à frente daria trilhões de posições. O truque do Stockfish é não olhar tudo. Ele usa o alfa-beta, uma poda que corta galhos que não podem mudar a decisão. A ideia, nas palavras de John McCarthy, um dos pais do método: uma refutação basta pra descartar um lance. Se você já achou uma resposta que torna o lance ruim, não precisa procurar uma resposta ainda pior.
Com os lances bem ordenados (os mais promissores primeiro), o alfa-beta reduz o trabalho de forma brutal: no melhor caso, é como se a árvore tivesse metade da profundidade. Em cima disso, o Stockfish empilha dezenas de truques: aprofundamento iterativo, tabela de transposição (memória de posições já vistas), redução de lances pouco promissores e por aí vai.
Um lance do Stockfish, passo a passo
- Recebe a posição.
- Busca com profundidade 1, depois 2, depois 3, e assim por diante (aprofundamento iterativo). Cada rodada usa o resultado da anterior pra ordenar melhor os lances.
- Em cada galho, testa primeiro os lances mais promissores: capturas boas, lances que já funcionaram antes.
- Poda os galhos que já foram refutados (alfa-beta).
- Quando chega na ponta da busca, avalia a posição com a rede neural (NNUE).
- Sobe essas notas pela árvore até a raiz e escolhe o lance com melhor nota.
- Repete até o tempo acabar.
Como funciona por dentro: avaliação (a NNUE)
A busca diz "o que pode acontecer". A avaliação diz "essa posição é boa ou ruim?". Até 2020, essa nota vinha de regras escritas à mão por especialistas: peão passado vale tanto, rei exposto perde tanto. Em agosto de 2020, o Stockfish trocou essas regras por uma rede neural chamada NNUE e, segundo o anúncio oficial, ganhou mais de 80 pontos de Elo de uma vez.
NNUE significa Efficiently Updatable Neural Network, rede neural atualizável de forma eficiente. Ela foi inventada pelo Yu Nasu para o shogi (o xadrez japonês), entrou na engine YaneuraOu em maio de 2018 e foi trazida para o xadrez pelo Hisayori Noda em 2019.
A analogia: pensa numa planilha enorme com o placar de todas as peças. Quando você move um cavalo, não faz sentido recalcular a planilha inteira. Você subtrai a linha do cavalo na casa antiga e soma a linha do cavalo na casa nova. A NNUE faz exatamente isso. Segundo a documentação oficial, ela segue três princípios:
- Pouquíssimas entradas ligadas ao mesmo tempo (nas arquiteturas atuais, cerca de 0,1% das entradas).
- Entradas que mudam o mínimo possível de um lance pro outro.
- Uma rede simples o bastante pra rodar com números inteiros, rápido, no processador comum.

Para devs: HalfKP e o acumulador
A primeira arquitetura do Stockfish usava um conjunto de entradas chamado HalfKP. Cada entrada é uma combinação de "onde está o meu rei" com "onde está tal peça". São 64 casas do rei vezes 64 casas da peça vezes 5 tipos de peça (sem o rei) vezes 2 cores: 40.960 entradas por lado. A rede aprende as peças sempre em relação ao rei, o que faz sentido no xadrez.
A primeira camada transforma essas entradas num vetor chamado acumulador. Quando uma peça se move, o acumulador é atualizado com uma subtração e uma soma. A exceção é o rei: como todas as entradas dependem da casa dele, quando o rei se move o acumulador inteiro precisa ser recalculado. A documentação aceita esse custo porque, na média, o número de atualizações por avaliação continua baixo.

Repare que a rede é rasa de propósito. Ela precisa rodar milhões de vezes por segundo dentro da busca, então cada microssegundo conta. A força vem da combinação: rede pequena e rápida avaliando, busca profunda calculando.
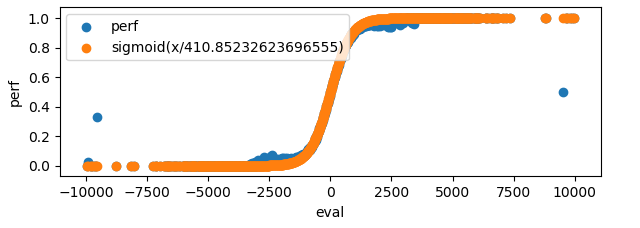
A rede aprende a traduzir a nota interna em chance de vitória. O gráfico abaixo mostra como a avaliação em centipeões vira probabilidade de resultado:
Como ele melhora: Fishtest
Toda mudança no Stockfish passa pelo Fishtest, uma rede de computadores de voluntários que joga milhares de partidas entre a versão nova e a antiga. Se a mudança não ganha Elo com significância estatística, ela não entra. O Stockfish 19, por exemplo, trouxe a arquitetura SFNNv16 e treino com quantização, e a equipe relata ganho de até 44 pontos de Elo sobre a versão 18.
Limites
- Ele te dá o melhor lance contra um oponente perfeito. Não diz qual lance é mais difícil pra um humano.
- A nota (+0,3, -1,2) é uma estimativa. Duas posições "iguais" podem ser muito diferentes na prática.
- Todo mundo tem ele. Isso é o ponto do vídeo.
Dica: no Lichess, abra qualquer partida, ligue a análise e olhe as três melhores linhas, não só a primeira. Quando a segunda ou a terceira opção tem nota parecida mas leva a uma posição bem menos comum, é exatamente esse tipo de lance que os profissionais estão usando pra surpreender.
2. AlphaZero: a IA que aprendeu sozinha
O que é
Em 2017, a DeepMind (Google) apresentou o AlphaZero, uma IA que aprendeu xadrez, shogi e Go sem nenhum conhecimento humano além das regras. Os resultados saíram na revista Science em dezembro de 2018. Ele não está disponível pra uso público.
Como funciona por dentro
A analogia: uma criança que nunca leu um livro de xadrez, trancada numa sala jogando milhões de partidas contra si mesma. No começo, joga aleatório. Aos poucos, percebe que certos padrões ganham mais. Ninguém ensinou nada, ela descobriu.
Tecnicamente, o AlphaZero junta duas peças:
- Uma rede neural profunda que olha uma posição e devolve duas coisas: quais lances parecem promissores (a policy) e quem tende a ganhar (o value).
- Uma busca em árvore Monte Carlo (MCTS) guiada por essa rede. Em vez de olhar tudo, ela explora mais os lances que a rede acha bons.
O contraste com o Stockfish é grande. Segundo a DeepMind, o AlphaZero analisava cerca de 60 mil posições por segundo, contra uns 60 milhões do Stockfish. Ele olhava mil vezes menos posições e ainda assim jogava melhor, porque escolhia muito melhor onde olhar.

Como ele aprendeu, passo a passo
- Começa com uma rede que não sabe nada.
- Joga uma partida contra si mesmo, usando a busca guiada pela rede.
- Guarda cada posição, os lances que a busca preferiu e quem ganhou no fim.
- Treina a rede pra prever esses lances e esse resultado.
- Volta ao passo 2 com a rede um pouco melhor.
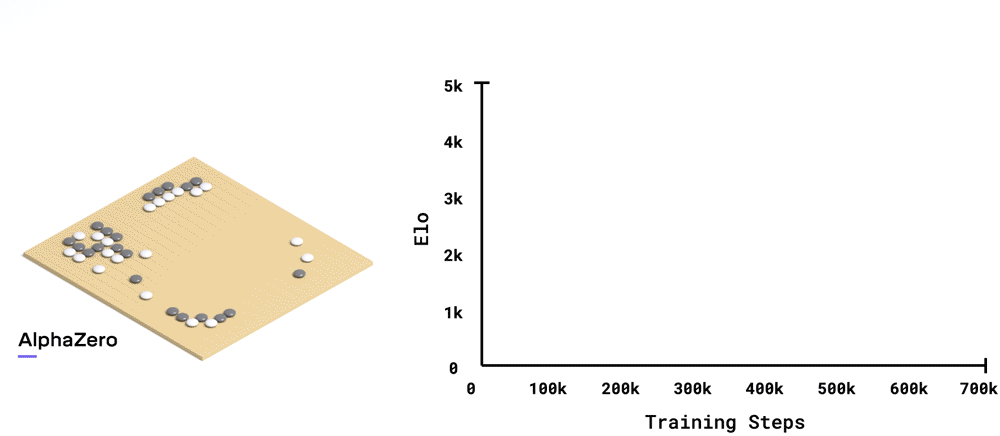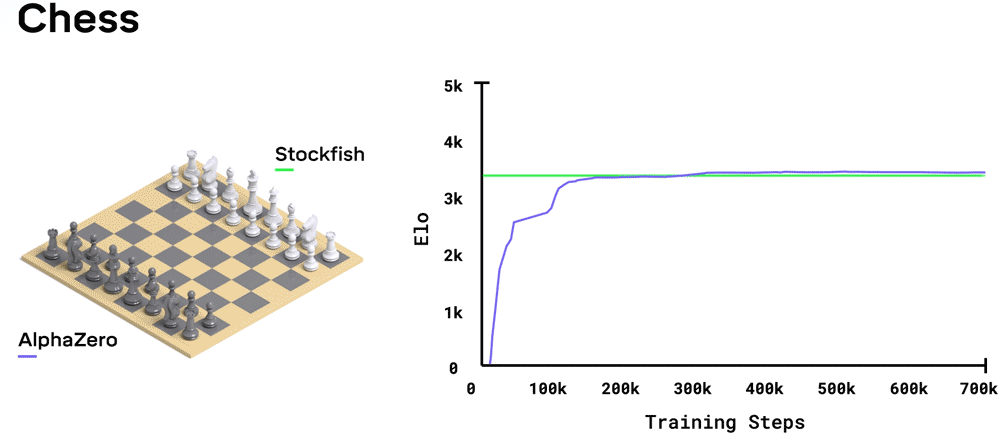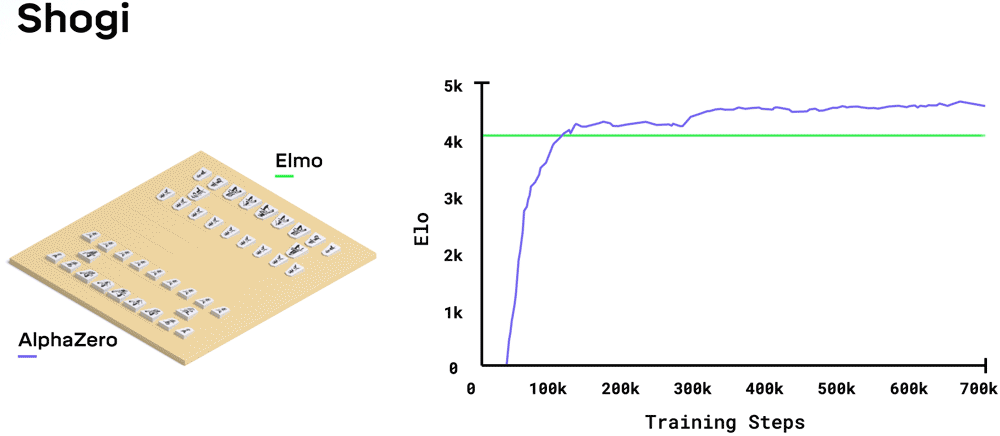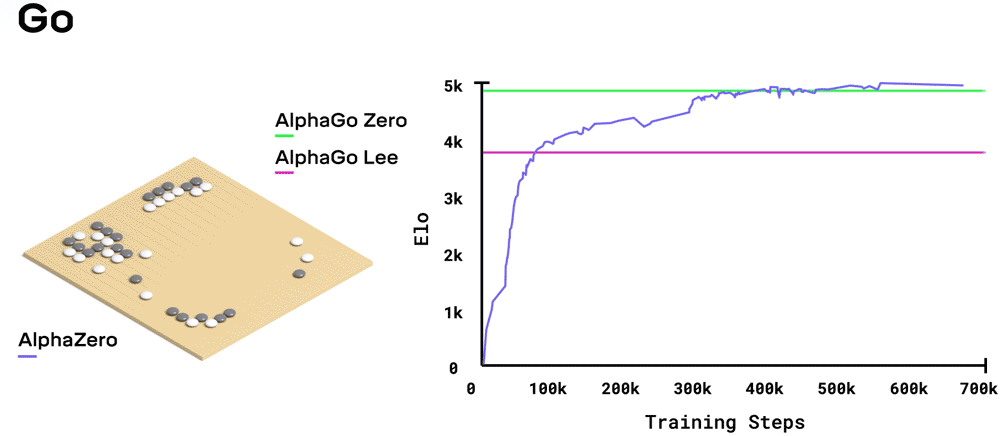
No xadrez, isso levou 9 horas pra superar o Stockfish da época. No shogi, 12 horas. No Go, 13 dias.
O match
Num match de 1.000 partidas contra o Stockfish, segundo a DeepMind, o AlphaZero venceu 155, perdeu 6 e empatou 839. O jogo dele chamou atenção pelo estilo: sacrifícios de material por atividade, ataques longos. O Kasparov disse que não conseguia esconder a satisfação de ver que ele jogava com um estilo dinâmico, "muito parecido com o meu".
Limites
- Precisou de hardware do Google pra treinar e não foi liberado.
- O Stockfish de hoje, com NNUE, é muito mais forte que o Stockfish que o AlphaZero enfrentou. A ideia ficou, o programa ficou pra história.
Dica: se você quer ver o "estilo AlphaZero" em ação, procure as partidas comentadas do match no canal oficial da DeepMind ou em análises no YouTube. Repara nos sacrifícios de peão pra ganhar espaço: é o tipo de ideia que mudou como os humanos jogam.
3. Leela Chess Zero: o AlphaZero aberto
O que é
O Leela Chess Zero (Lc0) começou em janeiro de 2018, criado pelo Gary Linscott a partir do Leela Zero, um projeto de Go. A ideia: refazer o AlphaZero de forma aberta, já que o original nunca foi liberado. É grátis e open source (GPLv3).
Como funciona por dentro
Mesma receita do AlphaZero: rede neural que dá policy e value, busca em árvore guiada pela rede (a variante usada se chama PUCT) e aprendizado jogando contra si mesma.
O diferencial está no treino. Em vez de um datacenter do Google, o Leela usa voluntários. Gente do mundo inteiro roda o programa em casa, gera partidas de autojogo e manda pros servidores do projeto, que treinam novas versões da rede.
A arquitetura também mudou. Por anos, a rede foi convolucional (do mesmo tipo usado em reconhecimento de imagem). Segundo o Chessprogramming Wiki, a partir de 2022 o projeto migrou para transformers, a mesma família de arquitetura dos modelos de linguagem.
Resultados
O Leela venceu o Stockfish nas superfinais do TCEC (o principal campeonato de engines) nas temporadas 15 (2019) e 17 (2020). Depois da NNUE, o Stockfish voltou a dominar, mas o Leela segue entre as engines mais fortes.
Como começar
- Baixe o Lc0 no GitHub do projeto.
- Baixe uma rede (os pesos) no site do Lc0.
- Instale uma interface gráfica de xadrez que aceite engines UCI (Nibbler, Cute Chess, Arena).
- Aponte a interface para o executável do Lc0.
Limites
- Precisa de placa de vídeo pra jogar bem. No processador comum, fica bem mais fraco.
- Pra análise rápida no dia a dia, o Stockfish no Lichess resolve.
Dica: o Leela mostra a chance de vitória, empate e derrota (WDL) além da nota. Isso ajuda a entender posições "iguais" que na prática são muito mais fáceis pra um lado.
4. Maia: a IA que erra como gente
O que é
A Maia é uma IA treinada pra fazer o contrário das outras: em vez de achar o melhor lance, ela tenta prever o lance que um humano daquele nível faria. Foi criada por pesquisadores da Universidade de Toronto, Cornell e Microsoft Research. O primeiro artigo saiu no KDD 2020, a Maia-2 no NeurIPS 2024 e a Maia-3 no ICLR 2026.
Por que isso importa
O Stockfish é ótimo pra dizer o que é certo. Mas ele não sabe o que é difícil. A Maia sabe onde humanos costumam errar, o que faz dela um parceiro de treino mais realista e uma ferramenta pra estudar justamente o que o vídeo mostra: onde a preparação humana falha.
Como funciona por dentro
Os pesquisadores treinaram a rede com 12 milhões de partidas do Lichess, separadas por faixa de rating (1100 a 1900 no primeiro artigo). O detalhe técnico mais interessante: eles desligaram a busca. Segundo o artigo, a busca em árvore é essencial pra jogar forte, mas atrapalha na hora de prever o lance humano. Então a Maia responde só com a "intuição" da rede.
Os números
Segundo o artigo de 2020, a Maia acertou entre 46% e mais de 52% dos lances humanos, dependendo da faixa. O Stockfish ficou entre 33% e 41%, e o Leela chegou a 46%. Ou seja: a engine que joga melhor é a que pior prevê o que as pessoas vão jogar.

Como começar
- Entre em maiachess.com.
- Jogue contra a Maia no seu nível ou analise partidas suas.
- Veja onde ela "acha" que você erraria. É ali que seu adversário também pode errar.
Limites
- Ela imita jogadores do Lichess online, que jogam diferente de grandes mestres no clássico.
- Prever o lance mais provável não é o mesmo que prever o lance de uma pessoa específica.
Dica: analise uma abertura sua com o Stockfish e com a Maia lado a lado. Lances em que o Stockfish dá nota parecida, mas a Maia diz que humanos erram muito a resposta, são candidatos perfeitos pra surpreender.
E o ChatGPT? Ele joga xadrez?
Joga, mas mal, porque não foi feito pra isso. Modelos de linguagem não calculam a árvore de jogo nem têm uma avaliação treinada como a NNUE. Eles preveem texto. Em agosto de 2025, o Kaggle fez um torneio de exibição entre modelos de linguagem. O o3, da OpenAI, venceu o Grok 4 por 4 a 0 na final, mas a cobertura do Chess.com registra lances como entregar um cavalo de graça e não conseguir dar mate com torre e rei. Qualquer Stockfish de celular venceria todos eles.
Comparação: as IAs lado a lado
| Deep Blue (1997) | Stockfish (hoje) | AlphaZero (2017) | Leela (hoje) | Maia | |
|---|---|---|---|---|---|
| Como avalia | Regras feitas à mão | Rede NNUE pequena e rápida | Rede neural profunda | Rede neural (transformer) | Rede neural treinada em humanos |
| Como busca | Força bruta com hardware dedicado | Alfa-beta muito otimizado | MCTS guiado pela rede | PUCT guiado pela rede | Sem busca |
| Posições por segundo | 200 milhões (IBM) | Dezenas de milhões | 60 mil | Poucas, mas bem escolhidas | Uma avaliação por lance |
| Aprendeu com | Programadores e mestres | Partidas analisadas pela própria engine | Só autojogo | Autojogo com voluntários | Partidas humanas do Lichess |
| Objetivo | Vencer o Kasparov | Achar o melhor lance | Achar o melhor lance | Achar o melhor lance | Prever o lance humano |
| Disponível? | Não | Grátis | Não | Grátis | Grátis |
Como usar engine pra estudar sem virar refém dela
Juntando o que os profissionais citados aqui fazem, dá pra montar um método simples:
- Primeiro pense sozinho. Jogue a partida ou analise a posição sem engine. Anote o que você jogaria.
- Depois consulte a máquina. Veja onde sua ideia diverge da engine e por quê.
- Olhe além da primeira linha. Procure lances com nota parecida que levam a posições menos comuns.
- Estude a fundo o que escolher. O Pragg não chutou o 4...f5: ele preparou com o treinador. Surpresa sem preparação é só lance ruim.
- Teste com a Maia. Veja se a resposta certa ao seu lance é difícil de achar pra um humano.
Pra ir mais fundo
Artigos e reportagens
- AI changed chess: grandmasters now win with unpredictable moves (Bloomberg, março de 2026): a reportagem que inspirou o vídeo, com o caso do Mundial de 2018.
- AI has mastered chess, so humans are changing the rules (Techspot): boa síntese de como os jogadores reagiram, incluindo o Freestyle Chess.
- Candidates R3: Adventurous Pragg takes down Vidit (ChessBase): o relato da partida do vídeo, com análise.
- Relato oficial da 3ª rodada (FIDE): de onde vêm os tempos gastos pelo Vidit.
Estudos
- Technology Shocks, Relative Performance Measures, and Outcomes: Evidence from Classical Chess (Ben-Moshe e Genesove, 2026): o estudo dos 3,9 milhões de partidas e do aumento dos empates.
- A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play (Science, 2018): o artigo do AlphaZero.
- Aligning Superhuman AI with Human Behavior: Chess as a Model System (KDD 2020): o primeiro artigo da Maia, com os números de acerto.
Documentação
- Documentação da NNUE: o guia mais completo sobre a rede do Stockfish, com código e diagramas. Pesado, mas excelente.
- Introducing NNUE Evaluation (Stockfish, 2020): o anúncio da mudança que deu mais de 80 de Elo.
- Stockfish 19: o que mudou na versão atual.
- Alpha-Beta no Chessprogramming Wiki: a história e a matemática da poda.
- Leela Chess Zero no Chessprogramming Wiki: história, arquitetura e resultados do Lc0.
Pra brincar
- AlphaZero no blog da DeepMind: infográficos e partidas.
- Maia Chess: jogue contra uma IA que erra como você.
- Freestyle Chess: o circuito com posições sorteadas.
Glossário rápido
- Engine: programa que joga e analisa xadrez. O Stockfish é uma engine.
- Elo: sistema de pontuação que mede a força relativa de jogadores (e engines).
- Árvore de jogo: todas as sequências de lances possíveis a partir de uma posição.
- Alfa-beta: técnica que corta galhos da árvore que não podem mudar a decisão.
- NNUE: rede neural pequena que se atualiza só com o que mudou no tabuleiro. É a avaliação do Stockfish.
- MCTS / PUCT: busca em árvore que explora mais os lances que a rede neural considera promissores.
- Autojogo (self-play): a IA aprende jogando contra si mesma.
- Policy e value: as duas saídas da rede do AlphaZero e do Leela: quais lances parecem bons e quem tende a ganhar.
- TPU: chip do Google feito pra treinar e rodar redes neurais.
- Transformer: arquitetura de rede neural que também é a base dos modelos de linguagem como o ChatGPT.
- Preparação: o estudo de aberturas feito antes da partida, hoje quase todo com engine.
Pra fechar
A IA não matou o xadrez. Ela mudou onde está a vantagem: quando todo mundo tem o mesmo gabarito, ganha quem sabe sair dele com preparação. Tem mais páginas assim no Cofre. Se quiser receber a próxima antes de virar vídeo, assina a newsletter aqui do lado.