Materiais do vídeo
Como a OpenAI escala o Postgres do ChatGPTArtigo · OpenAI · inglês↗Como a Figma chegou ao shardingArtigo · Figma · inglês↗Como a Notion dividiu o Postgres em 480 pedaçosArtigo · Notion · inglês↗Sharding com animações interativasArtigo · PlanetScale · inglês↗Use The Index, Luke (índices do zero)Site · grátis · inglês↗Padrões de cache com RedisDocumentação · AWS · inglês↗Partições no PostgreSQLDocumentação · PostgreSQL · inglês↗Réplicas de leitura no PostgreSQLDocumentação · PostgreSQL · inglês↗Introdução ao SQL (meu guia)Cofre · guia↗Como escalar um banco de dados: a escada completa
O passo a passo do vídeo, explicado sem pressa: índice, cache, réplicas, fila, partição e sharding, com os comandos, os custos escondidos de cada degrau e como OpenAI, Figma e Notion fizeram na vida real.
Você veio do vídeo de como escalar um banco de dados e aqui está a versão completa. Cada degrau da escada tem o que ele resolve, como fazer na prática, o custo que ninguém conta e o sinal de que chegou a hora de subir para o próximo. No fim tem três casos reais (OpenAI, Figma e Notion), os vídeos e os textos que eu usei, e um glossário. Se você nunca escreveu uma consulta em SQL, passe antes no meu guia Introdução ao SQL e volte pra cá.
Resumo pra quem tem pressa
A ideia central do vídeo cabe numa frase: resolva o gargalo que existe hoje, com a solução mais simples que funciona. Cada degrau abaixo é mais complicado que o anterior, então você só sobe quando o de baixo não dá mais conta.
| Degrau | O que resolve | O que custa | Sinal de que é hora |
|---|---|---|---|
| 1. Máquina mais forte | Tudo, por um tempo | Dinheiro. Uma hora acaba o tamanho de máquina | CPU, memória ou disco sempre no limite |
| 2. Índices | Consultas lentas que leem a tabela inteira | Cada escrita fica um pouco mais pesada | Uma consulta frequente demora e lê milhões de linhas |
| 3. Cache | A mesma leitura repetida milhares de vezes | Dado velho, se você não invalidar direito | Poucas consultas respondem pela maior parte da carga |
| 4. Réplicas de leitura | Leitura demais para um servidor só | A réplica chega um pouco atrasada | O principal sofre com leitura, não com escrita |
| 5. Fila | Trabalho que não precisa acontecer na hora | Mais uma peça para monitorar | A resposta ao usuário espera tarefas que podiam ficar pra depois |
| 6. Partição | Uma tabela gigante demais | Regras novas pra manter as partições | Uma tabela tem bilhões de linhas e você quase só consulta as recentes |
| 7. Banco certo pra cada carga | Busca, sessão, arquivo e análise brigando no mesmo banco | Mais sistemas pra cuidar | Uma carga que não é "de banco relacional" pesa no principal |
| 8. Sharding | Escrita demais para um servidor só | Muito alto: consultas entre pedaços, redistribuição, operação | Você já fez tudo acima e a escrita continua no limite |
Antes de tudo: descubra onde dói
Escalar sem medir é chute. Antes de mudar qualquer coisa, responda: o banco está sofrendo com leitura ou com escrita? É uma consulta ou o volume todo? Os remédios são diferentes.
No PostgreSQL, dois comandos resolvem boa parte dessa investigação:
-- Mostra como o banco executa a consulta e quanto tempo cada parte leva
EXPLAIN ANALYZE
SELECT * FROM users WHERE email = '[email protected]';
Se no resultado aparecer Seq Scan numa tabela grande, o banco está lendo linha por linha. É o caso clássico de índice faltando.
-- Lista as consultas que mais consomem tempo no total
-- (precisa da extensão pg_stat_statements ativada)
SELECT query, calls, total_exec_time, mean_exec_time
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
Dica: olhe o tempo total, não só o da consulta mais lenta. Uma consulta de 5 milissegundos chamada 2 milhões de vezes por dia pesa muito mais do que uma de 3 segundos chamada uma vez.
1. Um banco só, numa máquina mais forte
Todo app começa assim: login, posts, mensagens e perfis no mesmo banco, no mesmo servidor. E isso é ótimo. É fácil de entender, de fazer backup e de consertar.
Quando ele começa a sofrer, o primeiro passo é o mais sem graça e o que mais funciona: comprar uma máquina maior. Mais processador, mais memória e disco mais rápido. Isso se chama escala vertical.
Pensa numa cozinha de restaurante. Antes de abrir uma segunda cozinha, você troca o fogão de 4 bocas por um de 8. A equipe continua a mesma, o cardápio continua o mesmo e nada muda no jeito de trabalhar.
Por que ela vai mais longe do que parece: a memória é o que mais ajuda. Quando os dados mais usados cabem na memória, o banco quase não precisa ir ao disco, que é muito mais lento.
O limite: uma hora não existe máquina maior para comprar, ou ela fica cara demais. A Figma, por exemplo, contou que em 2020 rodava em um único Postgres na maior instância física que a AWS oferecia. A partir daí, crescer exigia outra estratégia.
2. Índices: o atalho que evita ler tudo
Imagine procurar a palavra "fotossíntese" num livro de biologia de 800 páginas. Sem índice remissivo, você lê página por página. Com o índice no fim do livro, você vai direto para a página 214.
O índice do banco é isso. Se o seu app busca usuário por e-mail o tempo todo, sem índice o banco lê a tabela inteira a cada busca. Com índice, ele vai direto na linha certa.
CREATE INDEX idx_users_email ON users (email);
O custo que pouca gente conta: o índice precisa ficar sincronizado com a tabela. Toda vez que você insere, altera ou apaga uma linha, o banco atualiza o índice junto. A documentação do PostgreSQL diz isso com todas as letras: depois de criado, o índice adiciona trabalho às operações de escrita, e índices pouco usados devem ser removidos.
Ou seja, índice não é "quanto mais, melhor". Crie para as consultas que realmente pesam e apague o que ninguém usa.
Em produção, use o CONCURRENTLY. O CREATE INDEX normal trava as escritas na tabela até terminar. Numa tabela grande, isso pode levar minutos com o app sem conseguir salvar nada. A versão concorrente demora mais, mas não trava:
CREATE INDEX CONCURRENTLY idx_users_email ON users (email);
Dica: a ordem das colunas num índice composto importa. Um índice em
(cidade, sobrenome)ajuda quem busca por cidade, ou por cidade e sobrenome. Quem busca só por sobrenome não aproveita. O site Use The Index, Luke, gratuito, explica isso melhor do que qualquer curso pago.
3. Cache: não pergunte a mesma coisa 100 mil vezes
Se um perfil é visto 100 mil vezes num dia, não faz sentido perguntar ao banco 100 mil vezes a mesma coisa. Você guarda a resposta num lugar muito mais rápido, na memória, e consulta ali primeiro. O exemplo mais famoso desse tipo de ferramenta é o Redis.
É como o garçom que já sabe de cor o prato do dia. Ele só vai até a cozinha perguntar quando o cardápio muda.
O jeito mais comum de usar se chama cache-aside (ou carregamento sob demanda):
- O app procura o dado no cache.
- Se achou, responde na hora.
- Se não achou, busca no banco, guarda uma cópia no cache e responde.
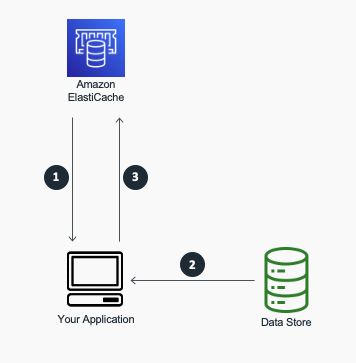
O custo: dado velho. O cache guarda uma cópia. Quando o dado muda no banco, a cópia precisa ser apagada ou atualizada, senão a pessoa vê o perfil antigo. As saídas mais usadas:
- Prazo de validade (TTL): cada item expira sozinho depois de um tempo. Simples, mas aceita alguns segundos ou minutos de dado velho.
- Apagar ao escrever: quando o perfil muda, o app apaga a cópia. A próxima leitura busca a versão nova.
- Escrever nos dois (write-through): o app atualiza o banco e o cache juntos.
A armadilha do "estouro de manada": quando um item muito acessado expira, milhares de pedidos chegam ao mesmo tempo, todos acham o cache vazio e todos vão ao banco. A OpenAI contou que resolve isso com uma trava: só um pedido vai ao banco buscar o dado, e os outros esperam o cache ser preenchido.
Dica: cache bom é o que guarda pouca coisa muito pedida. Antes de colocar Redis, veja no
pg_stat_statementsquais consultas se repetem mais. Muitas vezes, três ou quatro consultas respondem pela maior parte da leitura.
4. Réplicas de leitura: cópias que respondem as perguntas
Na maioria dos apps, as pessoas leem muito mais do que escrevem. Você abre o feed cem vezes para cada post que publica.
A réplica de leitura aproveita isso. O banco principal recebe todas as escritas e manda as mudanças para cópias dele. Essas cópias respondem as leituras.
- Atualizou o perfil? Vai pro principal.
- Mil pessoas olhando perfis? Divide entre as réplicas.
É como uma escola com uma única secretaria que pode alterar notas, mas com várias cópias do mural de resultados espalhadas pelos corredores. Todo mundo consulta o mural mais perto. Só a secretaria escreve.
O custo: atraso. A cópia demora um pouquinho para chegar. A documentação do PostgreSQL avisa que a mesma consulta rodada ao mesmo tempo no principal e na réplica pode dar resultados diferentes. O nome técnico é consistência eventual: a réplica fica igual ao principal, mas não no mesmo instante.
Na prática, o problema aparece assim: você troca sua foto de perfil, a página recarrega lendo da réplica e mostra a foto antiga. Parece que não salvou.
Como contornar: logo depois de uma escrita, leia daquela pessoa no principal por alguns segundos. O nome disso em inglês é read your own writes, "leia o que você mesmo escreveu".
Um detalhe que derruba muita gente: conexões. Cada conexão aberta com o Postgres consome memória do servidor. Com muitos servidores de app, você estoura o limite antes de estourar a CPU. A solução é um pool de conexões, como o PgBouncer, que reaproveita poucas conexões para muitos pedidos. A OpenAI contou que, com o PgBouncer, o tempo médio para abrir conexão caiu de 50 para 5 milissegundos nos testes dela.
5. Fila: o que não precisa ser na hora, fica pra depois
Quando alguém curte um post, o app precisa mesmo, antes de responder, atualizar as estatísticas, recalcular as recomendações e mandar notificação? Provavelmente não. Só a curtida precisa ser salva na hora.
A fila separa as duas coisas:
- O app salva a curtida e responde na hora.
- Ele coloca um recado numa fila: "o post 123 foi curtido pela Ana".
- Programas em segundo plano (os workers) pegam os recados um por um e fazem o trabalho pesado.
É o caixa da padaria que anota seu pedido de bolo e libera você. A confeitaria faz o bolo no tempo dela.
O que você ganha: a resposta fica rápida, e um pico de acessos vira uma fila mais longa, em vez de um banco derrubado. A AWS resume bem: a fila amortece cargas que chegam em rajadas.
O que custa: mais uma peça para monitorar e um novo tipo de erro. Se o worker cair, os recados acumulam, e as notificações chegam atrasadas. Ferramentas comuns para isso: RabbitMQ, Amazon SQS, Kafka, ou o próprio Redis em casos simples.
Dica: faça o worker aguentar receber o mesmo recado duas vezes. Em quase toda fila, uma mensagem pode ser entregue de novo depois de uma falha. Se o trabalho for "somar 1 curtida", processar duas vezes vira erro. Se for "marcar que a Ana curtiu o post 123", repetir não estraga nada.
6. Partição: quebrar a tabela gigante em gavetas
Uma tabela de eventos com bilhões de linhas fica lenta para consultar, para apagar dado antigo e para fazer manutenção. A partição divide essa tabela em pedaços menores, dentro do mesmo banco: um pedaço por mês, por região ou por cliente.
Pensa num arquivo de papel. Em vez de uma gaveta só com dez anos de notas fiscais, você tem uma gaveta por mês. Quando alguém pede as notas de março, você abre só a gaveta de março.
No PostgreSQL, a partição por data fica assim:
-- A tabela "mãe" não guarda dados, só define a regra
CREATE TABLE eventos (
    id         bigint,
    usuario_id bigint,
    tipo       text,
    criado_em  date NOT NULL
) PARTITION BY RANGE (criado_em);

-- Uma partição por mês (o início entra, o fim não)
CREATE TABLE eventos_2026_09 PARTITION OF eventos
    FOR VALUES FROM ('2026-09-01') TO ('2026-10-01');

CREATE TABLE eventos_2026_10 PARTITION OF eventos
    FOR VALUES FROM ('2026-10-01') TO ('2026-11-01');
Quando você consulta com WHERE criado_em >= '2026-10-01', o banco sabe que o mês de setembro não tem nada disso e nem abre aquela partição. Isso se chama poda de partições (partition pruning).
O maior presente da partição é apagar dado velho. Apagar um mês inteiro com DELETE numa tabela gigante é lento e deixa sujeira para o banco limpar depois. Com partição, você remove a gaveta inteira, quase na hora:
DROP TABLE eventos_2025_01;
Quando não vale a pena: em tabela pequena. A própria documentação do PostgreSQL sugere, como regra prática, particionar só quando a tabela fica maior que a memória do servidor. E a consulta precisa filtrar pela coluna da partição, senão o banco abre todas as gavetas do mesmo jeito.
Partição não é sharding
Essa confusão é muito comum, inclusive no vídeo que eu usei de referência:
- Partição: a tabela é dividida em pedaços, mas todos ficam no mesmo servidor.
- Sharding: os dados são divididos entre servidores diferentes.
A partição organiza. O sharding espalha. A diferença muda tudo: num servidor só, ainda existe uma única fonte da verdade e transações funcionam normalmente. Em vários servidores, não.
7. Cada carga no banco certo
Em escala grande, você para de pedir tudo a um banco só. Cada tipo de dado vai para a ferramenta que lida melhor com ele:
| Carga | Ferramenta comum | Por quê |
|---|---|---|
| Contas, pedidos, pagamentos | PostgreSQL ou MySQL | Transações confiáveis e relações entre tabelas |
| Sessões e contadores | Redis | Tudo na memória, resposta em microssegundos |
| Busca por texto | Elasticsearch ou OpenSearch | Feito para buscar palavras, com relevância e erro de digitação |
| Fotos, vídeos e arquivos | Armazenamento de objetos (S3 e parecidos) | Barato para guardar muito volume |
| Relatórios e análises | Banco de colunas (ClickHouse, BigQuery) | Soma e agrupa bilhões de linhas rápido |
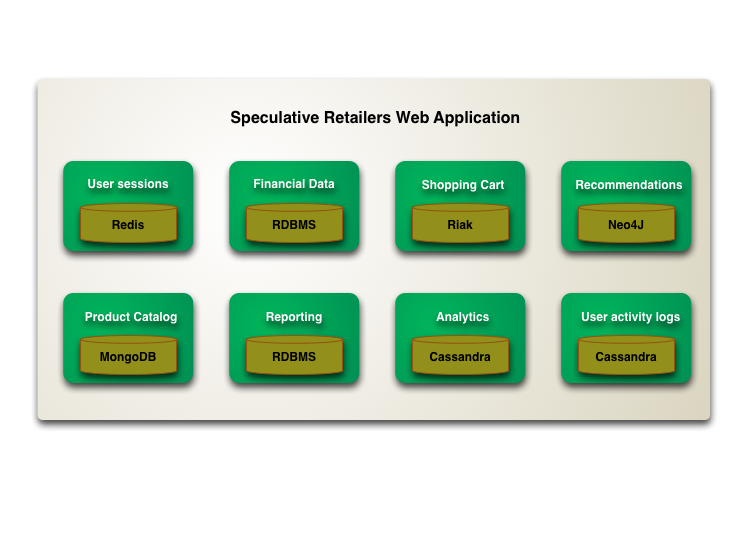
Martin Fowler deu um nome para isso em 2011: persistência poliglota. Ele mesmo avisa do custo: mais sistemas significam mais coisas para manter e mais cuidado para os dados não ficarem diferentes entre eles.
Dica: um sinal de que está na hora é quando a busca do seu app usa
LIKE '%palavra%'em tabela grande. Esse tipo de consulta não aproveita índice comum e lê tudo. Um motor de busca resolve melhor.
8. Sharding: o chefe final
Quando a escrita passa do limite de um servidor, réplica não ajuda, porque todas as escritas ainda passam pelo principal. Aí entra o sharding: você divide os dados entre vários bancos independentes, e cada um guarda só uma parte.
Pensa numa rede de escolas que cresceu demais para uma secretaria só. Ela abre uma secretaria por bairro, e cada uma cuida só dos alunos daquele bairro.

A escolha mais importante: a chave do shard
A chave do shard é a coluna que decide em qual banco cada linha mora. As duas formas mais comuns:
- Por faixa: usuários de 1 a 10 milhões no banco A, de 10 a 20 milhões no B. Fácil de entender, mas cria o shard quente: os usuários novos, que são os mais ativos, caem todos no último banco.
- Por hash: o sistema passa o ID por uma conta que espalha os valores de um jeito embaralhado e uniforme, e o resultado escolhe o banco. A carga fica bem distribuída.
Uma boa chave tem três características:
- Muitos valores diferentes, para espalhar bem (ID do usuário é ótimo; país é péssimo).
- Quase nunca muda, porque mudar a chave obriga a mover a linha de banco.
- Junta o que é consultado junto. Se tudo de um usuário fica no mesmo banco, a tela de perfil consulta um banco só.
Os problemas novos
- Consulta que precisa de todos os bancos. "Quantos usuários se cadastraram hoje?" agora pergunta a todos os bancos e soma as respostas. Mais lento e mais complicado.
- Transação entre bancos. Transferir algo de um usuário do banco A para um do banco B deixa de ser uma transação simples.
- Redistribuir. Quando um banco enche, você precisa mover dados com o app no ar, sem perder nada.
- Operação. Em vez de um backup, uma atualização e um monitoramento, agora são dezenas.
Por isso ele é o último degrau. E por isso a OpenAI, com o tamanho que tem, ainda não fez sharding no seu Postgres principal (detalhes logo abaixo).
Dica: se for fazer sharding, crie muito mais shards lógicos do que servidores. A Notion criou 480 shards lógicos distribuídos em 32 bancos físicos. Quando precisar de mais máquinas, você move shards lógicos inteiros de um servidor para outro, sem recalcular onde cada linha mora.
Três casos reais
OpenAI: um único Postgres principal para o ChatGPT
Em janeiro de 2026, a OpenAI publicou como o PostgreSQL aguenta o ChatGPT, que tinha cerca de 800 milhões de usuários segundo o próprio texto. O resumo:
- Um único servidor principal recebe todas as escritas, com uma cópia de reserva pronta para assumir se ele falhar.
- Quase 50 réplicas de leitura, espalhadas por várias regiões do mundo.
- Cache absorvendo a maior parte da leitura.
- PgBouncer na frente de cada réplica, para reaproveitar conexões.
- As escritas que dava pra dividir foram para sistemas com sharding, como o Azure Cosmos DB. Tabelas novas não entram mais no Postgres principal.
- Sharding do Postgres ficou para depois. O motivo: mexer em centenas de partes do sistema, um trabalho de meses ou anos.

A parte que mais ensina está nos erros. Um dos incidentes graves veio de uma consulta que juntava 12 tabelas de uma vez. E a OpenAI descreve um ciclo vicioso: o banco fica lento, os pedidos dão erro, os apps tentam de novo, a carga aumenta e o banco fica mais lento ainda. A recomendação deles é limitar a quantidade de pedidos em todas as camadas e não fazer novas tentativas em intervalos curtos demais.
Figma: adiar o sharding o máximo possível
A Figma conta que o banco dela cresceu quase 100 vezes de 2020 a 2024. A ordem que ela seguiu é quase a escada do vídeo:
- Um Postgres só, na maior máquina disponível.
- Cache e réplicas de leitura.
- Particionamento vertical: em vez de dividir uma tabela, separar grupos de tabelas relacionadas em bancos diferentes. No fim de 2022, eram cerca de uma dúzia de bancos.
- Sharding horizontal, só quando algumas tabelas passaram de terabytes e bilhões de linhas. A primeira tabela com sharding foi ao ar em setembro de 2023.
O motivo de adiar, nas palavras deles: o particionamento vertical era mais fácil e deu um bom tempo de fôlego.
Notion: quando esperar demais também custa
A Notion fez o caminho contrário e conta o preço. Em 2021, o banco único estava com picos de CPU e manutenções travadas. Ela dividiu tudo em 480 shards lógicos, usando o ID do workspace como chave, porque quase toda consulta acontece dentro de um workspace só.
A migração teve escrita dupla nos bancos velho e novo, cópia dos dados antigos por cerca de três dias e comparação dos resultados antes da troca. A lição que eles tiram: teriam feito antes. Esperar deixou a migração mais pesada, porque o banco antigo já estava no limite.
Juntando os três: começar distribuído é caro demais, e esperar demais também cobra. O segredo é medir e subir um degrau antes de bater no teto.
Lado a lado: réplica, partição e sharding
| Réplica de leitura | Partição | Sharding | |
|---|---|---|---|
| Onde ficam os dados | Cópia completa em outro servidor | Pedaços no mesmo servidor | Pedaços em servidores diferentes |
| Resolve | Excesso de leitura | Tabela gigante | Excesso de escrita e de volume |
| Escrita | Continua toda no principal | Continua num servidor só | Dividida entre os servidores |
| O app precisa mudar? | Pouco (mandar leitura para a réplica) | Quase nada | Bastante |
| Principal risco | Ler dado atrasado | Consulta sem filtro na coluna da partição | Consultas e transações entre bancos |
Os erros mais comuns
- Começar com arquitetura distribuída porque um dia você vai ter milhões de usuários. Você paga a complexidade hoje por um problema que talvez nunca chegue.
- Criar índice em tudo. Cada índice deixa as escritas mais lentas.
- Esquecer de invalidar o cache. O usuário edita o perfil e vê a versão antiga.
- Ler da réplica logo depois de escrever. Parece que o dado não foi salvo.
- Confundir partição com sharding. Partição não divide a carga de escrita entre máquinas.
- Escolher mal a chave do shard. Ela é muito difícil de trocar depois.
- Escalar sem medir. Sem
EXPLAINe sem saber quais consultas pesam, qualquer degrau é chute.
Vídeos
Uma aula em português sobre como escalar a leitura de um sistema, do Pedro Camaforte:
Sharding no MySQL e no Postgres, explicado com animações pelo Ben Dicken, da PlanetScale (em inglês, com legendas automáticas):
Pra ir mais fundo
Casos reais
- Scaling PostgreSQL to power 800 million ChatGPT users (OpenAI, 2026): o texto que inspirou o vídeo, com os erros e as soluções do dia a dia.
- How Figma's databases team lived to tell the scale (Figma, 2024): a melhor explicação que eu conheço de particionamento vertical antes do sharding.
- Herding elephants: lessons learned from sharding Postgres at Notion (Notion, 2021): uma migração para sharding contada passo a passo, com o que eles fariam diferente.
Para aprender cada degrau
- Use The Index, Luke: índices explicados para quem programa, grátis, com exemplos em PostgreSQL, MySQL, SQL Server e outros.
- Database Sharding (PlanetScale): artigo com animações interativas de shards, chave por faixa e por hash.
- Caching patterns (AWS): cache-aside e write-through com diagramas.
- What is a Message Queue? (AWS): filas explicadas do zero.
- Polyglot Persistence (Martin Fowler): o texto curto que deu nome à ideia de usar o banco certo para cada carga.
Documentação do PostgreSQL
- Introdução aos índices: inclui o aviso sobre o custo do índice nas escritas.
- CREATE INDEX: a opção CONCURRENTLY e os cuidados dela.
- Particionamento de tabelas: partição por faixa, por lista e por hash, e a poda de partições.
- Hot standby: como funcionam as réplicas de leitura e por que elas atrasam.
Livro
- Designing Data-Intensive Applications, de Martin Kleppmann: o livro de referência sobre replicação, partição e consistência. Denso, mas é o que mais ensina.
No Cofre
- Introdução ao SQL: a base para entender todos os comandos desta página.
Glossário rápido
| Termo | Em português claro |
|---|---|
| Escala vertical | Deixar a máquina mais forte |
| Escala horizontal | Usar mais máquinas |
| Índice | Um atalho que leva o banco direto à linha, sem ler a tabela toda |
| Cache | Uma cópia rápida, na memória, de respostas pedidas com frequência |
| TTL | O prazo de validade de um item no cache |
| Réplica de leitura | Uma cópia do banco que só responde consultas |
| Consistência eventual | A cópia fica igual ao original, mas com um pequeno atraso |
| Pool de conexões | Um intermediário que reaproveita poucas conexões para muitos pedidos |
| Fila | Uma lista de tarefas para fazer depois, em segundo plano |
| Worker | O programa que pega as tarefas da fila e executa |
| Partição | Um pedaço de uma tabela grande, no mesmo servidor |
| Sharding | Dividir os dados entre vários servidores independentes |
| Chave do shard | A coluna que decide em qual servidor cada linha fica |
| Shard quente | Um servidor que recebe muito mais carga que os outros |
Salve esta página para quando o seu banco começar a reclamar. Tem mais material assim no Cofre, e todo dia sai vídeo novo de tecnologia no @heliofilhou.